Imaginez une entreprise qui lance une nouvelle référence pour répondre à un besoin client. Quelques mois plus tard, un autre marché demande un conditionnement différent. Un distributeur impose son propre étiquetage. Un grand compte souhaite être livré plus rapidement. Une gamme historique est conservée malgré des volumes devenus faibles.
Aucune de ces décisions ne paraît particulièrement dangereuse. Chacune peut même être parfaitement justifiée commercialement.
Puis les années passent. Le catalogue grossit. Les variantes se multiplient. Les règles clients s’accumulent. Certaines commandes doivent être préparées différemment. Certaines références nécessitent leur propre stock. Les planners gèrent davantage d’exceptions. Les approvisionneurs surveillent des articles consommés quelques fois par an. L’entrepôt conserve des emplacements pour des produits qui tournent peu.
La Supply Chain fonctionne toujours. Mais elle devient progressivement plus difficile à exploiter.
Et une question devient alors beaucoup plus compliquée qu’elle n’en a l’air : combien toute cette complexité coûte-t-elle réellement ?
Une décision simple peut créer des coûts dans cinq endroits différents
Prenons une nouvelle variante produit. Pour le commerce, elle peut représenter un chiffre d’affaires supplémentaire. Pour le marketing, une meilleure réponse à un segment de clientèle. Vue sous cet angle, la décision peut être excellente.
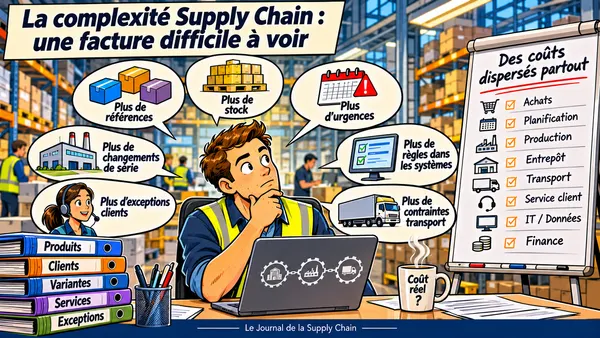
Mais cette même variante doit entrer dans les opérations. Il faut créer et maintenir ses données, prévoir sa demande, déterminer comment l’approvisionner ou la produire, définir son stock, lui trouver un emplacement, l’intégrer aux règles de préparation, parfois gérer un nouvel emballage ou une nouvelle étiquette, puis contrôler son niveau de service et traiter son éventuelle obsolescence.
Aucune de ces activités n’est forcément très coûteuse prise isolément. C’est précisément le problème.
Le coût de la complexité ne tombe presque jamais sur un seul département. Il se répartit entre les achats, la planification, la production, la master data, l’entrepôt, le transport, la finance et le service client.
Chaque équipe n’en absorbe qu’une petite partie. Le commerce voit la vente. Le planner voit une référence supplémentaire. L’entrepôt voit quelques mouvements. La finance voit un peu plus de stock. L’IT voit une règle supplémentaire.
Personne ne voit forcément l’addition complète.
Plus de choix ne signifie pas forcément plus de volume
Une entreprise peut vendre 100 000 unités d’une gamme réparties sur dix références. Quelques années plus tard, elle vend toujours 100 000 unités, mais réparties sur trente références.
Commercialement, l’offre est devenue plus riche. Opérationnellement, la situation a changé beaucoup plus profondément.
Chaque référence dispose maintenant d’un volume moyen plus faible. La demande devient plus fragmentée. Certaines prévisions deviennent moins fiables. Les lots minimums représentent davantage de couverture. Les risques de surplus augmentent. Certaines variantes tournent rapidement, d’autres restent plusieurs mois sans mouvement.
Le volume total n’a pourtant pas nécessairement augmenté. C’est le nombre de façons de servir ce volume qui a augmenté.
Cette distinction est importante parce qu’une Supply Chain ne gère pas uniquement des unités. Elle gère aussi des références, des emplacements, des paramètres, des ordres, des lots, des changements de série et des décisions.
À partir d’un certain niveau, une référence supplémentaire peut apporter très peu de volume tout en conservant presque toute sa charge de complexité.
Le stock finit souvent par révéler ce que les ventes ne montrent pas
La complexité commerciale se matérialise fréquemment dans le stock.
Une entreprise peut décider de conserver plusieurs variantes parce que chacune répond à un besoin spécifique. Mais si ces variantes ne sont pas interchangeables, elles doivent parfois être protégées séparément.
Un stock de sécurité concentré sur une référence standard peut couvrir plusieurs situations. Le même besoin réparti entre cinq références peut exiger cinq arbitrages différents.
Puis viennent les minimums de commande, les tailles de lot, les délais fournisseurs et les contraintes industrielles.
Un article faiblement consommé peut devoir être acheté par 500 alors qu’il s’en vend 50 par mois. Une référence spécifique à un client peut devenir presque inutilisable si ce client modifie son besoin. Un changement de packaging peut laisser derrière lui plusieurs semaines de couverture de l’ancienne version.
La complexité ne produit donc pas uniquement davantage de références dans l’ERP. Elle peut aussi immobiliser davantage de capital.
Et lorsque l’entreprise regarde uniquement sa valeur de stock globale, elle ne voit pas toujours quelle part de ce stock existe réellement pour financer la variété de son offre.
Deux clients qui rapportent autant peuvent coûter très différemment à servir
Prenons deux clients réalisant chacun un million d’euros de chiffre d’affaires annuel.
Le premier commande une fois par semaine, par palettes complètes, avec un délai relativement stable. Le second passe plusieurs commandes par jour, demande parfois quelques pièces, modifie régulièrement ses priorités, impose un emballage spécifique et exige des livraisons sur plusieurs sites avec des créneaux précis.
Le chiffre d’affaires est identique. La charge Supply Chain ne l’est pas.
Le deuxième client génère davantage de commandes, de lignes, de préparations, de documents, de transports, d’échanges avec le service client et probablement davantage d’exceptions.
C’est tout l’intérêt d’une approche de type cost-to-serve : ne plus seulement regarder ce qu’un client achète, mais les ressources nécessaires pour le servir.
Cette logique peut parfois produire des résultats inconfortables. Un client important commercialement peut être moins rentable qu’il n’y paraît une fois intégrés les coûts logistiques réels. À l’inverse, un client plus petit mais très standardisé peut consommer proportionnellement beaucoup moins de ressources.
La difficulté consiste ensuite à savoir quoi faire de cette information. Augmenter les prix ? Modifier le niveau de service ? Renégocier les conditions ? Standardiser certains flux ?
Mesurer la complexité ne donne donc pas automatiquement la décision. Mais cela évite au moins de la prendre à partir d’une vision incomplète.
Les urgences sont rarement facturées à leur vrai coût
Une commande urgente arrive. Le planner modifie ses priorités. L’entrepôt accélère la préparation. Le transport trouve une solution. Le client est livré.
L’organisation a réussi.
Mais que s’est-il passé autour de cette urgence ? Une autre commande a peut-être été déplacée. Une tournée a été modifiée. Un opérateur a changé d’activité. Un transport plus cher a été réservé. Un planning de production a été reconfiguré.
L’urgence ne consomme donc pas uniquement le temps nécessaire pour la traiter. Elle consomme aussi une partie de la stabilité de l’organisation.
Lorsque ces cas restent réellement exceptionnels, ce coût peut être acceptable. Une Supply Chain existe aussi pour absorber des aléas.
Mais lorsque les urgences deviennent quotidiennes, le fonctionnement change. Les équipes apprennent à conserver des marges de sécurité. Les plannings sont moins tendus qu’ils pourraient l’être. Certains collaborateurs savent qu’une priorité officielle sera probablement modifiée dans l’après-midi. Les transporteurs intègrent les demandes de dernière minute dans leurs habitudes.
Le coût de la complexité se transforme alors en capacité gardée disponible « au cas où ». Et comme cette capacité est déjà intégrée dans le fonctionnement quotidien, elle devient presque invisible.
Une grande partie de la complexité est payée en temps humain
C’est probablement l’une des raisons principales pour lesquelles elle reste difficile à mesurer.
Un planner passe dix minutes supplémentaires à corriger une proposition. Un approvisionneur relance manuellement une référence particulière. Un préparateur sait qu’un client exige une règle spécifique. Un key user corrige régulièrement une erreur que le système ne sait pas traiter. Un responsable logistique conserve un tableau Excel pour suivre quelques cas particuliers.
Aucun de ces événements ne justifie à lui seul un projet d’amélioration.
Mais lorsqu’on les additionne à l’échelle de plusieurs équipes, plusieurs sites et plusieurs années, ils représentent une quantité considérable de travail.
Ce temps n’apparaît pourtant pas dans un compte intitulé « coût de complexité ». Il se cache dans les effectifs, les heures supplémentaires, les réunions, les corrections manuelles, la formation et la dépendance à certaines personnes.
Tant que les équipes réussissent à absorber ces activités, l’entreprise peut même avoir l’impression que son modèle fonctionne correctement.
La limite apparaît souvent lorsqu’un collaborateur expérimenté part ou lorsque les volumes augmentent. Ce qui ressemblait auparavant à quelques adaptations montre alors combien le fonctionnement dépendait de connaissances non documentées et d’interventions humaines permanentes.
Le système d’information finit par raconter l’histoire de toutes les exceptions accumulées
La complexité ne reste pas uniquement dans les opérations. Elle entre progressivement dans les systèmes.
Un client exige une règle particulière. On adapte le WMS. Une gamme nécessite un processus différent. On crée un paramètre. Un pays impose un document supplémentaire. On ajoute une condition. Une usine utilise une exception historique. On la conserve lors du changement d’ERP.
Chacune de ces adaptations peut être parfaitement justifiée au moment où elle est créée.
Le problème apparaît quelques années plus tard, lorsqu’une organisation compte plusieurs centaines de règles dont personne ne sait précisément lesquelles sont encore nécessaires.
Supprimer une ancienne exception devient alors risqué. Il faudrait vérifier les clients, les produits et les flux qu’elle peut encore concerner.
La complexité métier est devenue de la complexité informatique. Elle ralentit les évolutions, alourdit les tests et rend les transformations plus difficiles.
C’est l’un des paradoxes de la digitalisation : un système peut automatiser énormément de complexité tout en permettant à l’entreprise d’en conserver davantage qu’elle ne pourrait en gérer manuellement.
L’automatisation ne supprime donc pas toujours la complexité. Elle peut aussi la rendre supportable plus longtemps.
Les moyennes donnent parfois une image trop rassurante
Une entreprise affiche 97 % de taux de service. Son coût logistique représente 8 % du chiffre d’affaires. La productivité de l’entrepôt reste stable.
Pris ensemble, ces indicateurs peuvent suggérer une Supply Chain relativement saine.
Mais les moyennes racontent mal la dispersion.
Quelques références peuvent concentrer une grande partie du stock dormant. Certains clients peuvent générer une majorité des urgences. Une petite proportion des commandes peut nécessiter beaucoup plus de manipulations que les autres. Quelques variantes peuvent provoquer l’essentiel des changements de série.
Le KPI global reste pourtant correct.
C’est pour cela que la complexité se détecte parfois mieux lorsqu’on descend d’un niveau : par client, par référence, par canal, par type de commande ou par famille de flux.
La question n’est plus seulement : « Quel est notre coût logistique moyen ? »
Elle devient : « Quelles parties de notre activité coûtent disproportionnellement cher à servir ? »
Cette différence peut complètement changer la lecture d’un portefeuille.
Toute complexité n’est pas mauvaise
Il serait néanmoins dangereux de conclure qu’une bonne Supply Chain devrait chercher systématiquement à supprimer variantes, services spécifiques et exceptions.
Certaines complexités sont précisément ce qui crée la valeur.
Un client peut accepter de payer davantage pour un service particulier. Une gamme très large peut constituer un avantage concurrentiel. Une personnalisation tardive peut permettre de répondre à plusieurs marchés. Un stock supplémentaire peut protéger une activité stratégique.
La question n’est donc pas : comment rendre la Supply Chain la plus simple possible ?
Elle est : quelle complexité mérite réellement d’être financée ?
Une entreprise peut parfaitement décider qu’un client complexe reste extrêmement intéressant. Mais cette décision devrait idéalement être prise en connaissant le coût de cette complexité.
Sinon, la flexibilité devient une sorte de service gratuit offert par la Supply Chain au reste de l’organisation.
Simplifier devient vite un sujet politique
Identifier une complexité inutile est une chose. La supprimer en est une autre.
Une référence peu rentable peut avoir été demandée par un client important. Un packaging spécifique peut appartenir à une stratégie marketing. Une promesse de livraison peut être utilisée comme argument commercial. Un stock élevé peut rassurer la production.
Chaque source de complexité possède souvent une raison d’exister et un responsable qui peut légitimement la défendre.
C’est pourquoi les projets de simplification deviennent rapidement transverses.
La Supply Chain peut démontrer qu’une référence coûte cher à maintenir. Mais elle ne décide pas seule de la retirer du catalogue. La finance peut identifier un stock très lent. Mais elle ne sait pas nécessairement quelles conséquences commerciales aurait sa suppression. Le commerce peut vouloir conserver un service spécifique. Mais il n’en voit pas toujours la charge opérationnelle complète.
Il faut donc arbitrer.
Et sans gouvernance claire, l’organisation possède un biais naturel : il est beaucoup plus facile d’ajouter une complexité que d’en retirer une.
Mesurer parfaitement n’est pas nécessaire pour commencer
Calculer exactement le coût de chaque référence, de chaque client et de chaque exception pourrait devenir un projet extrêmement lourd.
Il n’est pas nécessaire d’aller jusque-là pour progresser.
Quelques questions permettent déjà de faire apparaître des signaux intéressants : quelles références représentent très peu de chiffre d’affaires mais beaucoup de stock ? Quels clients génèrent le plus d’urgences ou de traitements manuels ? Quelles commandes nécessitent systématiquement une intervention particulière ? Quelles variantes concentrent les dépréciations ? Quels flux génèrent le plus de litiges ? Quelles règles clients empêchent la standardisation ? Combien d’exceptions sont encore gérées hors système ?
Il ne s’agit pas nécessairement d’obtenir un coût exact au centime.
Il s’agit d’identifier où l’organisation consomme beaucoup plus de ressources que la moyenne et de comprendre pourquoi.
À partir de là, plusieurs réponses deviennent possibles : supprimer, standardiser, automatiser, facturer différemment ou simplement accepter consciemment la complexité.
Une complexité choisie n’est pas la même chose qu’une complexité accumulée
Une Supply Chain mature peut être extrêmement complexe.
Elle peut servir des dizaines de pays, gérer plusieurs canaux, plusieurs niveaux de service et des milliers de références.
Le sujet n’est pas son niveau absolu de complexité. C’est sa capacité à expliquer pourquoi cette complexité existe.
Une variante a-t-elle encore une vraie utilité commerciale ? Un service spécifique est-il payé par le client ? Une référence lente contribue-t-elle réellement à l’offre ? Une exception historique est-elle encore nécessaire ? Une règle système correspond-elle toujours à une réalité opérationnelle ?
Certaines réponses justifieront parfaitement de conserver la complexité. D’autres montreront qu’elle n’existe plus que parce que personne n’a pris la décision de la supprimer.
Une entreprise connaît généralement très bien le chiffre d’affaires généré par un produit, un client ou un service. Elle connaît souvent beaucoup moins bien la quantité de travail, de stock, de capacité et d’exceptions Supply Chain nécessaire pour générer ce chiffre d’affaires.
Le véritable enjeu n’est donc peut-être pas de réduire la complexité. Il est de pouvoir distinguer celle qui crée réellement de la valeur de celle que l’organisation continue simplement à payer sans plus savoir pourquoi.